AI助力前端页面开发
记录一下在公司内部的一个关于AI生成H5页面的技术分享,主要面向非技术比如产品运营等人员
背景介绍
在传统上,制作一个专业的H5页面需要设计师出设计稿、前端工程师写代码,周期长且成本高。
AI工具已经历了从最初的LLM大模型到多模态模型的演变,显著提升了识别和生成能力。如今,市场上有许多工具可以实现多模态交互,例如通过深度学习和强化学习技术的结合,能够更智能地处理复杂任务。
关于页面生成,相信大家都见过一些能力不错的大模型可以快速从0到1生成一个H5页面,比如claude等。单一的工具都是从0到1完成任务,中间环节不好干预。问题:如何将模型的能力或者其他AI工具结合到每一个工作环节当中?
分享目标
在本次分享中,我将介绍一些AI工具,并演示如何整合这些工具,不仅仅是生成H5页面,而是从构思想法开始,一步步到设计图,再到最终的代码实现
通过这个分享,大家将了解如何高效利用AI工具,将创意转化为现实,更好的提升工作效率
工具介绍
首先对接下来要使用的一些工具做简单的介绍:
- Figma:在线UI/UX设计工具,支持实时协作与原型交互设计图。
- Cursor:AI编程助手,集成代码生成与智能补全功能,用来代码编辑。
- Weave:阿里的图生代码模型,通过图片生成前端代码,刚出来一周时间
- v0.dev:Vercel推出AI生成UI工具,一键转文本/图片,Figma设计图转为前端代码。
- Figma插件
- Semi:通过算法将Figma设计图转换为前端代码
- builder.io + loveable:
- Builder.io 是一个可视化建站平台
- Lovable.dev 是一个 AI 驱动的开发平台,主要用于帮助用户快速创建和开发应用程序
- Deepseek:深度求索研发的国产大模型
- GPT4.1:OpenAI多模态升级版,强化逻辑与长文本处理。
- Claude 3.7 Sonnet:混合推理模型,代码生成友好。
- Deep Research:用于生成长篇的研究报告,会细致的搜索每一个页面,然后生成一份报告文件
- 文生图/视频
- Stable diffusion:开源AI图像生成模型,支持文本生成图片
- https://stablediffusion3.net/zh-CN/app 不是官网但是可以使用的,每日免费10次
- Midjourney:AI图像生成工具,支持文本描述快速创作多风格数字艺术作品和Stable diffusion类似(付费)
- Sora:OpenAI文生图/视频模型,生成图片或者视频片段,每日免费生成6次图片
- Stable diffusion:开源AI图像生成模型,支持文本生成图片
- MCP:是概念,MCP 就像 USB-C 一样,可以让不同设备能够通过相同的接口连接在一起,大模型类似
- Figma-Context-MCP 开源库:Figma-Context-MCP是一个MCP (Model Context Protoco1)服务器,专门给Al编码助手(比如Cursor)提供Figma说设计文件的布局信息。它通过Figma API抓取设计数据(布局、样式等),转成简化的格式喂给LLM,让AI能直接根据Figma文件生成代码。
案例分析
比如我现在想创建一个端午节活动,按照正常流程来看,可能涉及的工作(包含前期到代码开发完成,非全流程):
- 需要想大概的交互玩法,需要哪些功能模块,具体内容不清楚
- 需要画原型,写逻辑
- 需要设计图
- 最后设计图到代码
- 制作宣传海报,banner图等一些物料
玩法搜集和AIGC素材生成
一般情况下,我们大概会先构思一个大致的玩法,这里我通过deepseek,以及deep research先帮我想一些核心玩法,提示词如下
1 | |
- 通过询问deepseek和deep research,以及手动搜索一些其他页面,我得到了一些核心玩法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70端午节H5活动设计
1. 页面结构
活动分为三个主要页面:
首页:活动介绍、任务列表、积分排行榜入口
游戏页面:小游戏集合(龙舟竞速、粽子接龙等)
任务与排行页面:签到、任务完成情况、积分排行榜
2. 核心玩法设计
(1)龙舟竞速小游戏
玩法:玩家通过按键(或重力感应)控制龙舟,避开水中的障碍物(如水草、木板),冲刺到终点。
传统元素:
龙舟形象设计:融入传统龙舟元素,如龙头、船桨等
背景场景:模拟端午节赛龙舟的河道场景
奖励机制:
完成比赛后根据时间排名获得积分
成立击败“对手龙舟”可获得加分
(2)粽子接龙
玩法:玩家通过点击屏幕合成粽子,按照正确顺序点击材料(如竹叶、糯米、肉),完成粽子后可以获得积分。
传统元素:
粽子制作过程:展示端午节传统粽子制作的流程
材料设计:使用竹叶、糯米、肉等传统材料
奖励机制:
完成一个粽子可获得一定积分
按照特定顺序完成可获得额外奖励
(3)艾草接力赛
玩法:玩家通过按键或重力感应控制角色在跑道上前进,收集艾草可以增加速度,避开障碍物。
传统元素:
角色形象:可选用穿着传统端午节服饰的人物
道具:艾草作为加速道具
奖励机制:
收集一定数量艾草后可以释放技能(如加速冲刺)
比赛结束后根据名次获得积分
(4)端午知识答题
玩法:玩家需要完成一系列关于端午节的知识问答,问题分为简单、_medium_和困难三个等级。
传统元素:
问题内容:涉及端午节的起源、习俗、龙舟文化、粽子的寓意等
奖励机制:
每答对一题可获得积分
连续答对五题可获得额外奖励
(5)积分排行榜
玩法:玩家通过完成小游戏和任务获取积分,进入排行榜
展示内容:
积分排行榜(前10名)
积分排行榜背景可以是端午节传统场景
奖励机制:
每日更新排行榜,前3名可获得丰厚奖励
提供分享功能,展示自己的排名
(6)任务模块
任务列表:
浏览某个页面(如“端午节文化了解”页面)
完成一次签到
分享活动到朋友圈或好友
完成特定小游戏
传统元素:
任务描述可以融入传统元素,如“插上艾草,驱邪避灾”
任务完成时的动画可以使用传统元素(如竹叶飘动)
(7)签到系统
玩法:连续签到7天,每天完成签到可获得积分和小礼物
传统元素:
签到界面可以采用传统粽子作为主题
每天的签到礼物可以是虚拟粽子(可集换奖品)
3. 技术实现
页面跳转:通过React Router实现页面切换
积分系统:使用Redux或Vuex管理积分状态
动画效果:使用Anime.js或GSAP实现页面过渡动画
数据存储:使用Local Storage存储用户积分和任务进度
4. 美术设计
色彩搭配:以红色、绿色为主,营造传统节日氛围
图案元素:融入龙舟、粽子、艾草等传统元素
背景音乐:使用轻快的传统音乐(如《龙舟赛》) - deep research:
通过询问deepseek,得到了以下核心玩法
- 赛龙舟,通过控制龙舟移动躲避障碍
- 包粽子,自定义拖拽包粽子
- 通过地图搜集艾草闯关答题
- 设立积分、徽章、装饰道具(如龙舟涂装、传统服饰等)作为活动即时奖励
这些是大概玩法的搜集,搜集完成以后,大概构思一下首页画一下原型:
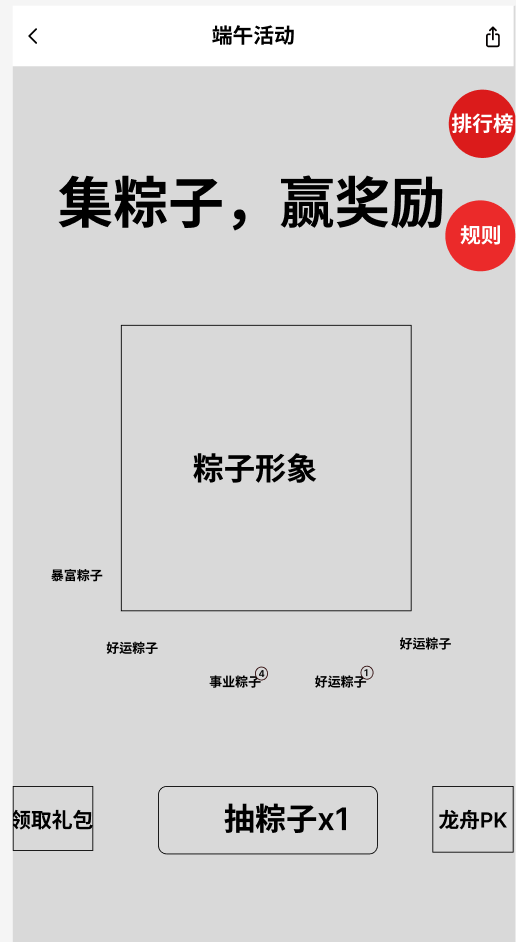
然后在花瓣网https://huaban.com/searc 搜集了一下素材,大概可能需要类似这样一个风格和展示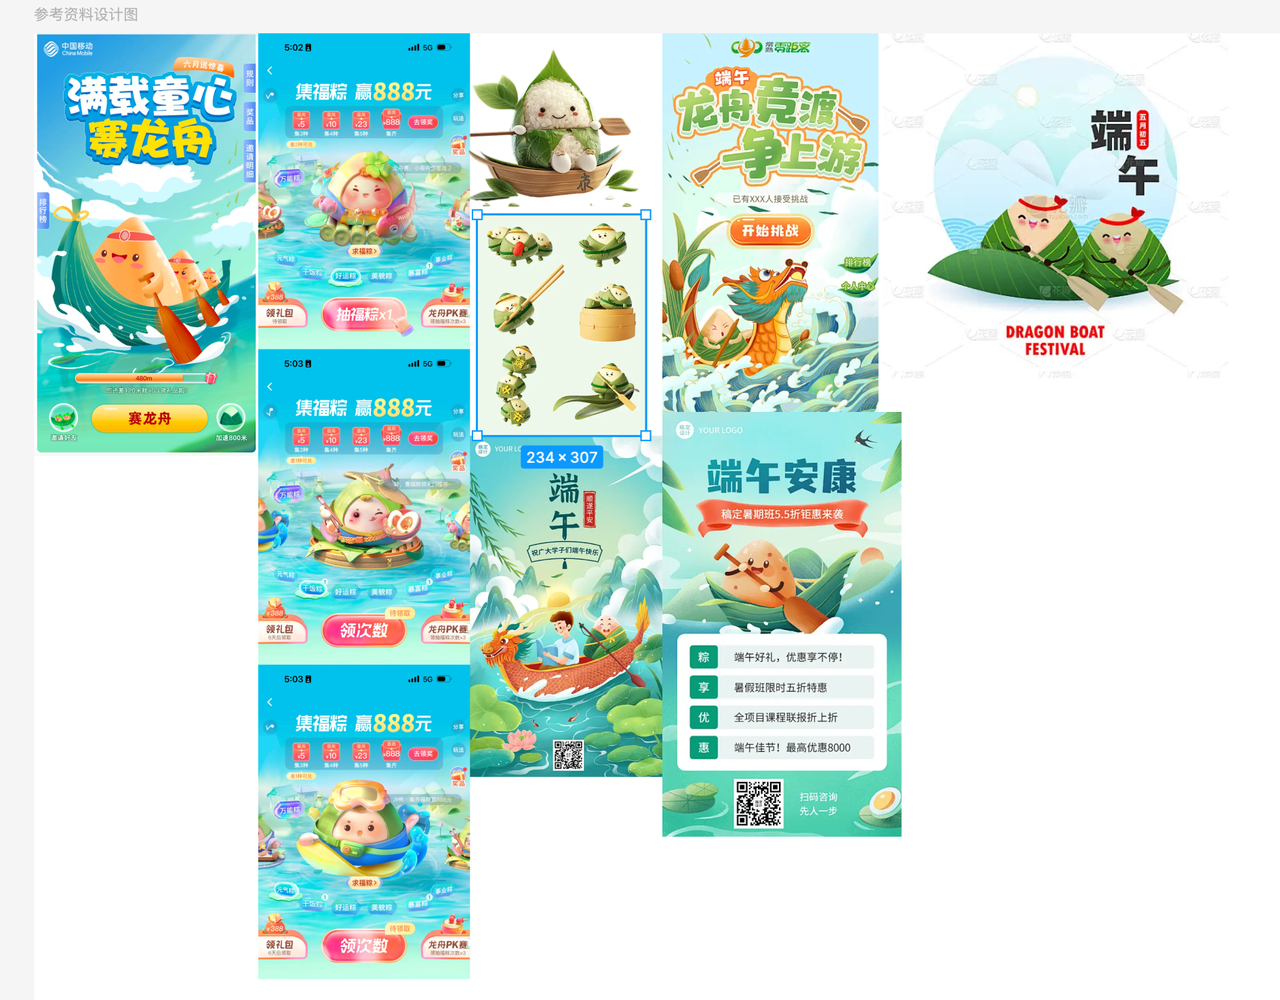
所以这里我们需要一些基本的Figma操作,然后把AIGC素材拼凑,比如页面中有粽子,按钮,背景等元素。
- 通过截图元素给GPT,尝试让GPT来生成对应内容的提示词,比如
“这是一个粽子,帮我生成在midjourney的提示词,需要有关键字Chinese rice dumpling,风格可以是扁平风格带一点3D效果“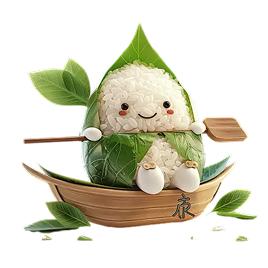
- 根据提示词,使用Stable Diffusion或者midjourney来生成素材 https://www.midjourney.com/imagine,然后将元素在Figma进行一些拼接设计,这里可以优先考虑midjourney,因为可以上传风格参考图片来生成,但是目前midjourney不太好生成透明背景,可以丢给一些AI的抠图工具去除一下背景。https://www.remove.bg/zh
我这里做了一个简单的设计,增加了一些其他元素,完成效果(忽略风格细节仅仅演示流程),如果要实现更加精细的风格需要自己继续尝试每个元素风格组成

这里我尝试了很多主流的一些工具,对于复杂布局的页面展示,都无法将直接给到的图片和布局信息来生成一个基本可用的风格,最接近的Sora可以看一下,看起来更接近海报,大家可以自己尝试更换提示词继续摸索,目前市面上没有这种生成式UI能够自动化完成
一样让GPT生成Sora中的提示词
“这是一个端午节活动,中间主体是一个粽子,帮我想一下背后的提示词,我要在sora中生成,注意页面风格,不要过度泛黄,整体颜色轻快”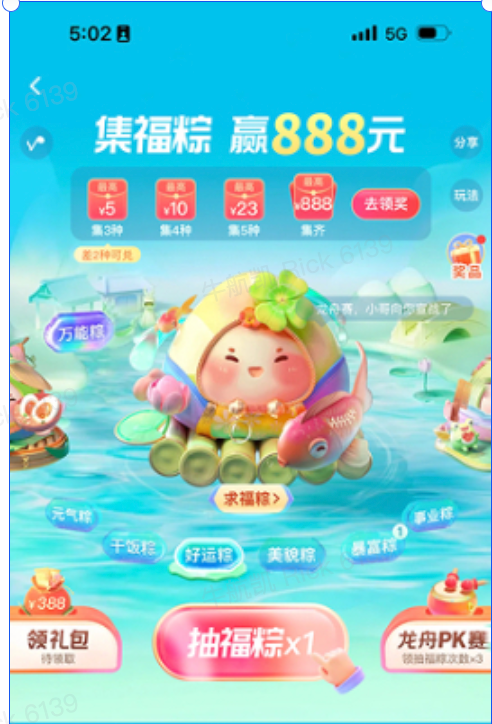
上面仅仅是对于使用AIGC辅助完成一些设计以及玩法查找的思路
代码生成
我们有几方法将设计图转换为代码
- 使用Figma的Semi插件
- 使用Weave
- 使用v0或者其他类似工具
- 使用builder.io + loveable
- 再次对话修改功能内容
- 使用Cursor+Claude3.7+MCP:需要一定的编程技术,借助MCP技术+开源项目:https://github.com/GLips/Figma-Context-MCP 因为可以获取到Figma元数据,比截图识别会更加准确
因为我这里的设计图只是示意,大部分都是图片,所以直接把我的图给到上面的工具生成效果一般,我这里用一张相对标准的设计图来实现生成代码的效果,大多数情况下,规范的设计对于生成代码的效果很更好
比如这个设计稿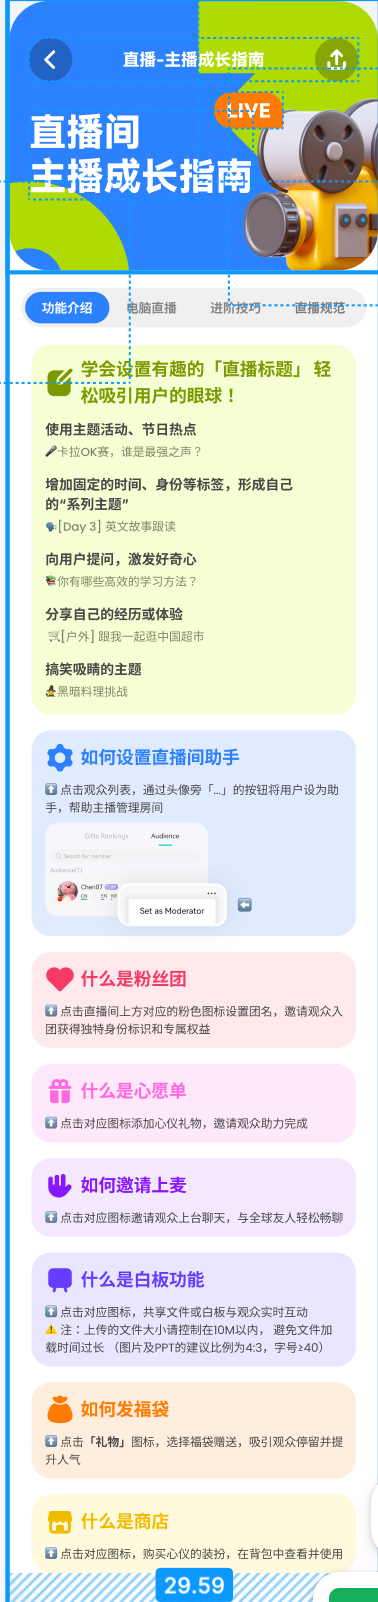
- 使用Figma的Semi插件生成代码效果:https://vvp7y7.csb.app/
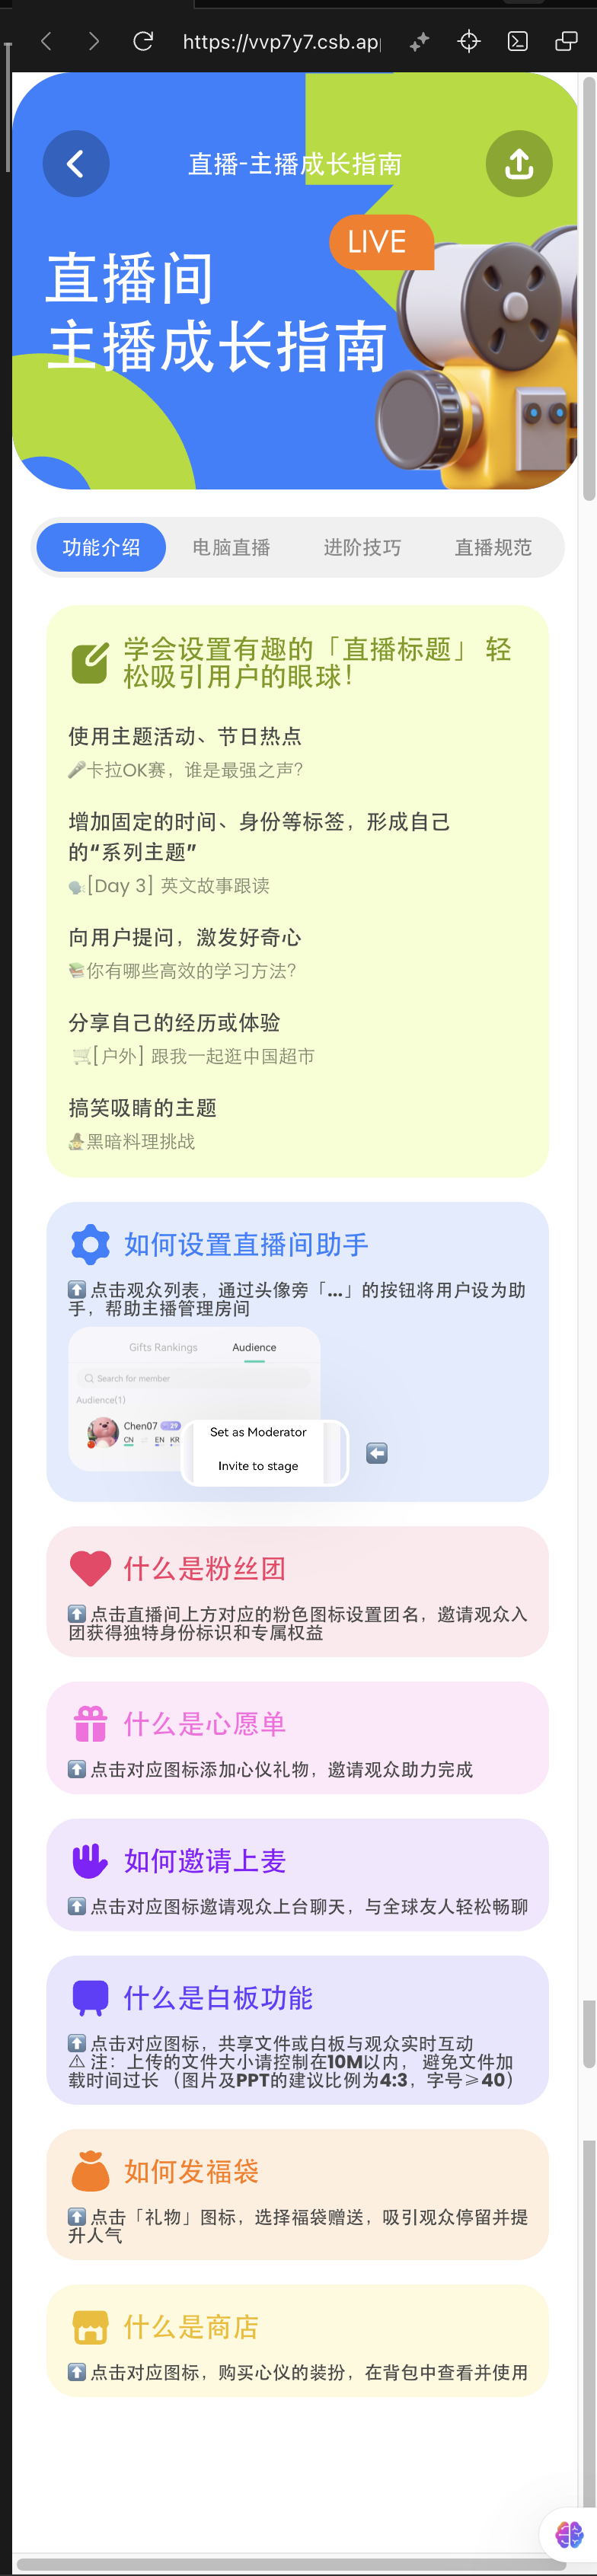
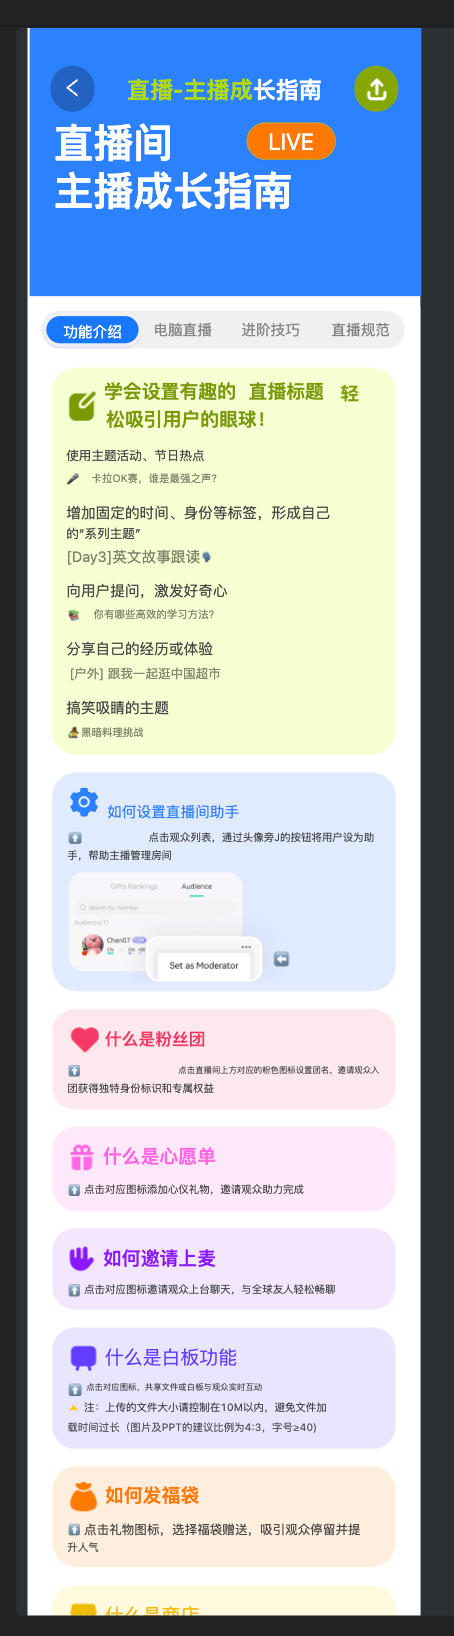
- 使用v0,这里和下面使用类似,有时候不稳定:https://v0.dev/chat/recreate-figma-ui-tWz2naaIJR7
- 使用builder.io + loveable 通过几轮对话来修改页面内容:https://lovable.dev/projects/8da6876e-2522-4c64-9265-ac9b64868870
- 使用Cursor+Claude3.7+MCP:http://127.0.0.1:5500/index.html 不仅实现了样式,还有tab切换功能都已经实现
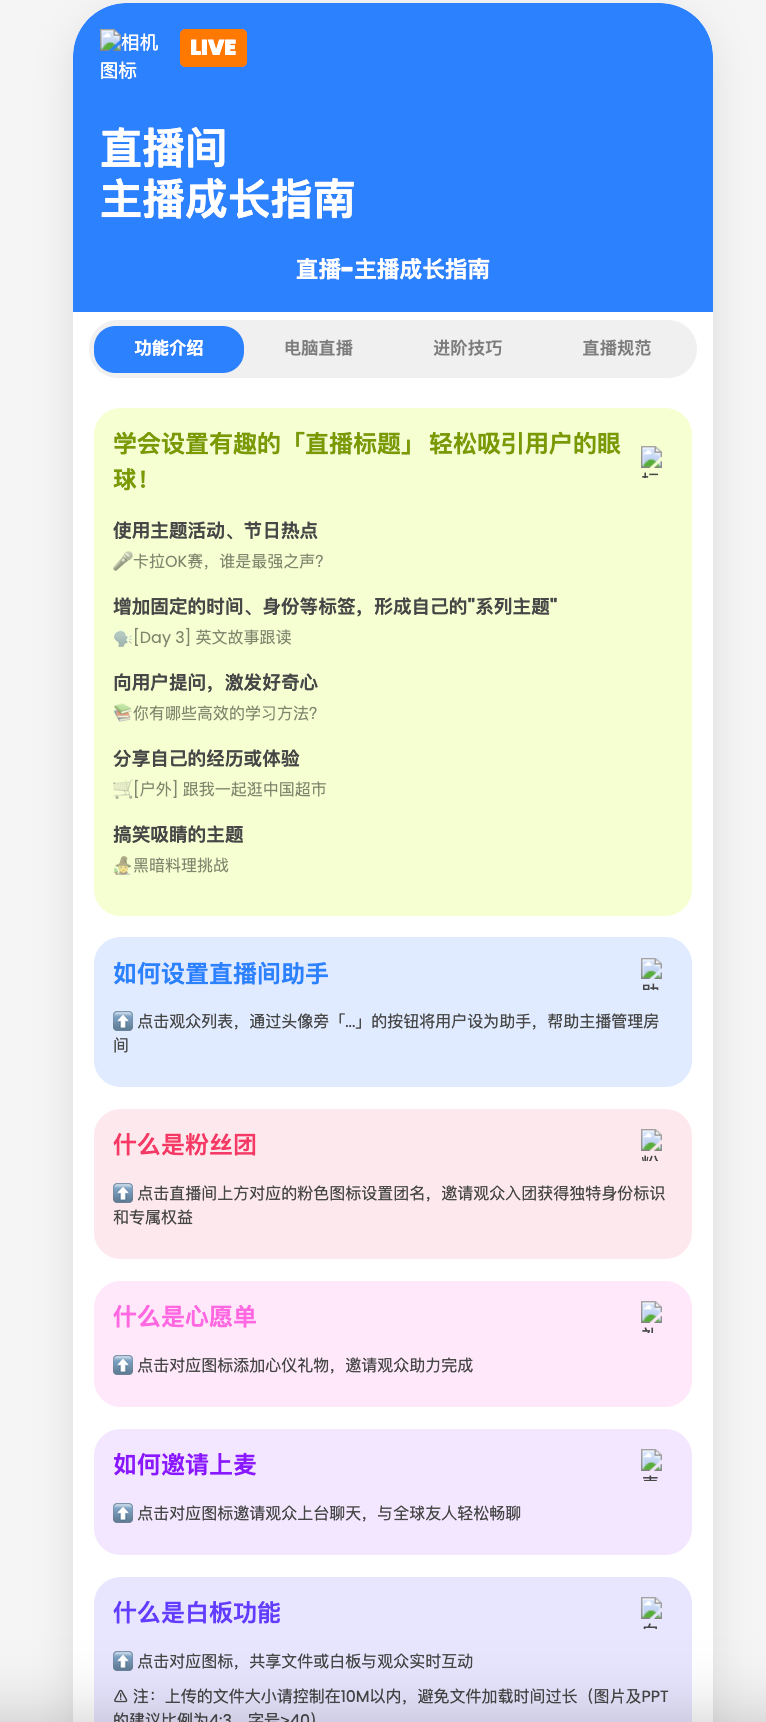
如何来区分使用场景?
- 对于有开发经验或者爱折腾的,可以尝试 Cursor+Claude3.7+MCP,效果会更好
- 如果没有编程经验,可以尝试v0或者builder.io + loveable来实现
- weave适合没有Figma设计稿只有截图的情况下生成
- Semi:生成比较快速,因为是算法生成,可以对比着看,没交互简单的页面可以使用
提示词编写
核心原则:具体、丰富、减少歧义,将AI视为协作伙伴而非工具。
其他类
高效提示词模板
一个完整的提示词通常包含以下要素:
- 角色定义:赋予AI一个专业角色,如”你是一位资深UI设计师和前端开发专家”
- 任务指示:明确描述需求,如”设计一个xxxH5页面”
- 背景信息:提供必要的上下文
- 参考示例:提供类似案例或风格参考
- 格式要求:指定输出格式,便于后续处理
模型特性与优化技巧
- GPT系列:偏好Markdown格式,提示词结构化更易获得好结果
- Claude:对XML格式更友好,可以用标签明确划分不同部分
OpenAI的官方prompt教程:https://platform.openai.com/docs/guides/prompt-engineering
建议经常多用不同的大模型,感受每一个词语不同带来的页面的变化,试是常用方案。另外上面的提示词只是提醒一些别遗漏的内容,并非固定模板。
也可以让大模型帮你补全提示词,做一些优化。
比如下面的示例,用markdown格式
1 | |
图片类
社交媒体
可以多关注微博,小红书,推特等三方平台,这些平台会有很多关于提示词的创意的博主,在发现好玩的玩法后会第一时间发布,关注热门博主可以捕捉到一些最新鲜的提示词。Sora或者midjourney
Sora和midjourney可以看到其他人的作品,而且提示词都是公开的,可以从别人的提示词当中找到这些创意加以借鉴。我找了一些觉得不错的海报,比如:反向分析
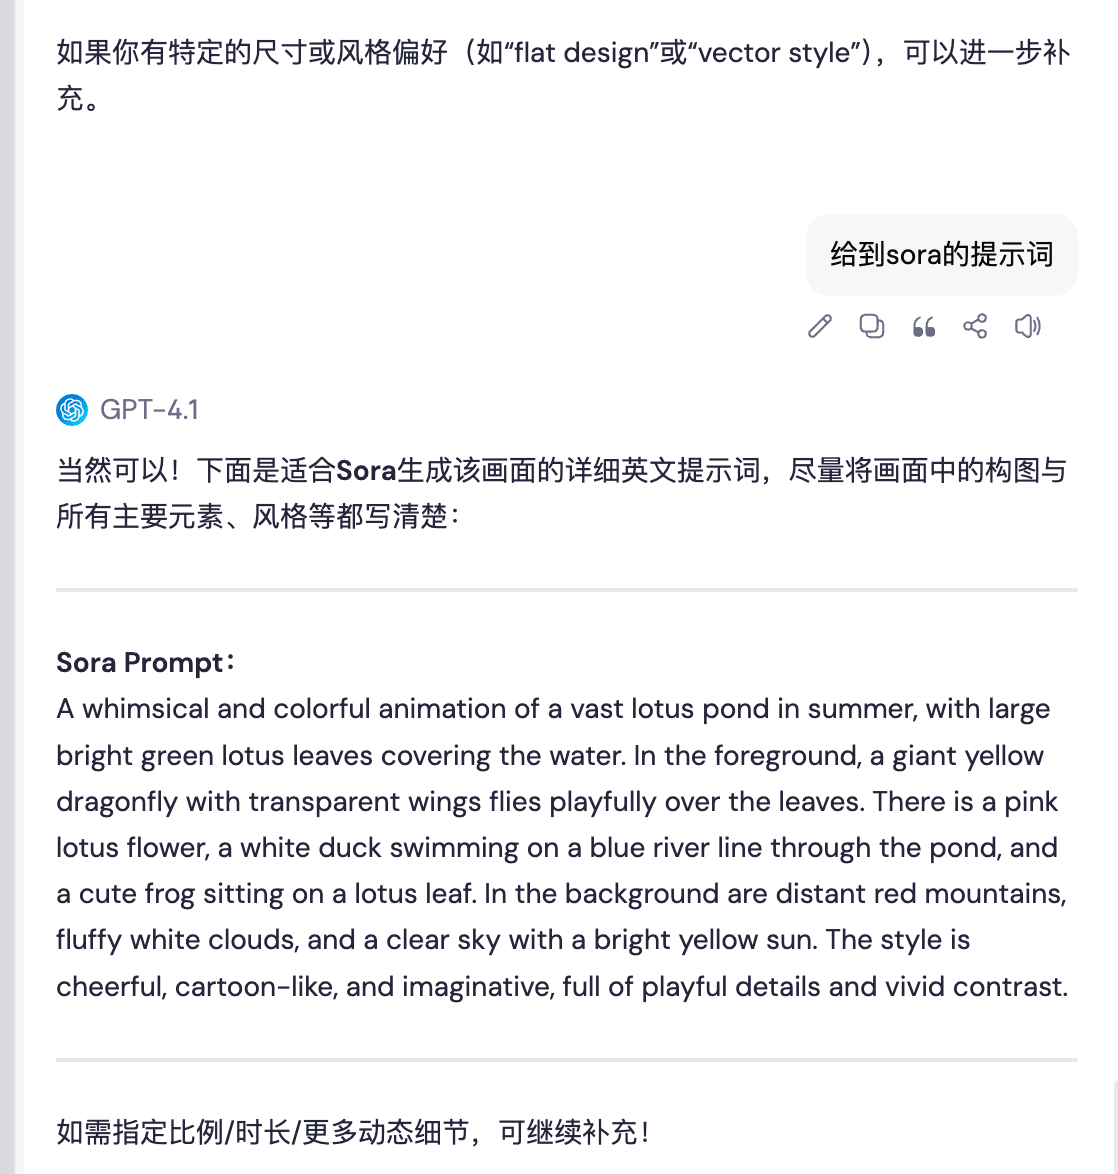
如我上面演示的内容,看到一个不错的图,反问GPT:“帮我想一下这个图片的提示词”,GPT有很大概率往往能准确猜出图片背后的提示词内容,然后可以在此基础上做一些调整,就可以达到具体想要的效果
- 练习,模仿,融合
简单来说就是除了输入还要输出,自己多尝试,多生成几次之后,认真观察图片呈现的细节,再对比提示词的内容,就能发现提示词具体是如何影响图片效果的。
多练习,和不同的大模型沟通尝试,多用几次之后往往就能感受到展示出来的细节呈现不同之处。比如图片生成,有些加一些强调风格的比如:吉卜力风,像素风,未来感等
可以在sora和midjourney以及GPT4之间多对比一下
这里有一个开源项目都是提示词模板,涵盖各个方面 https://github.com/langgptai/wonderful-prompts
值得关注的一些工具
Imagen:谷歌的文本生图片功能,可以直击通过prompt对图像进行修改编辑
Figma AI
- 目前功能比较初级,但是期待后续发展,支持一键抠图,翻译,提示词生成原型&设计稿等,目前账号没权限,仅作简单描述
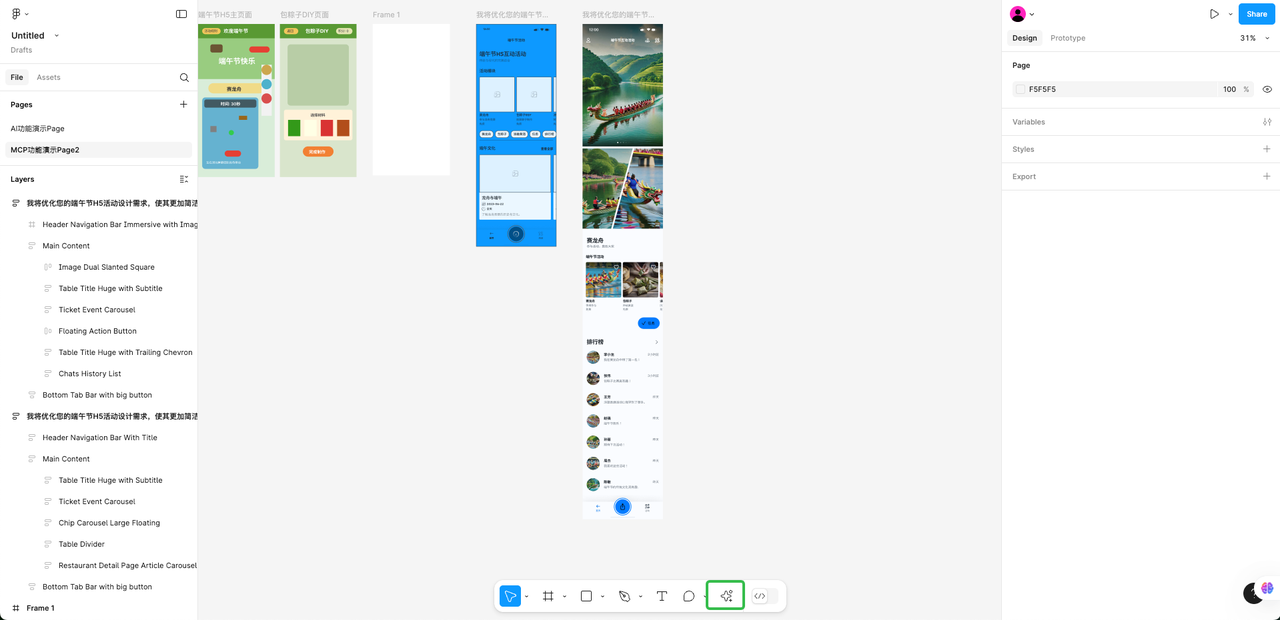
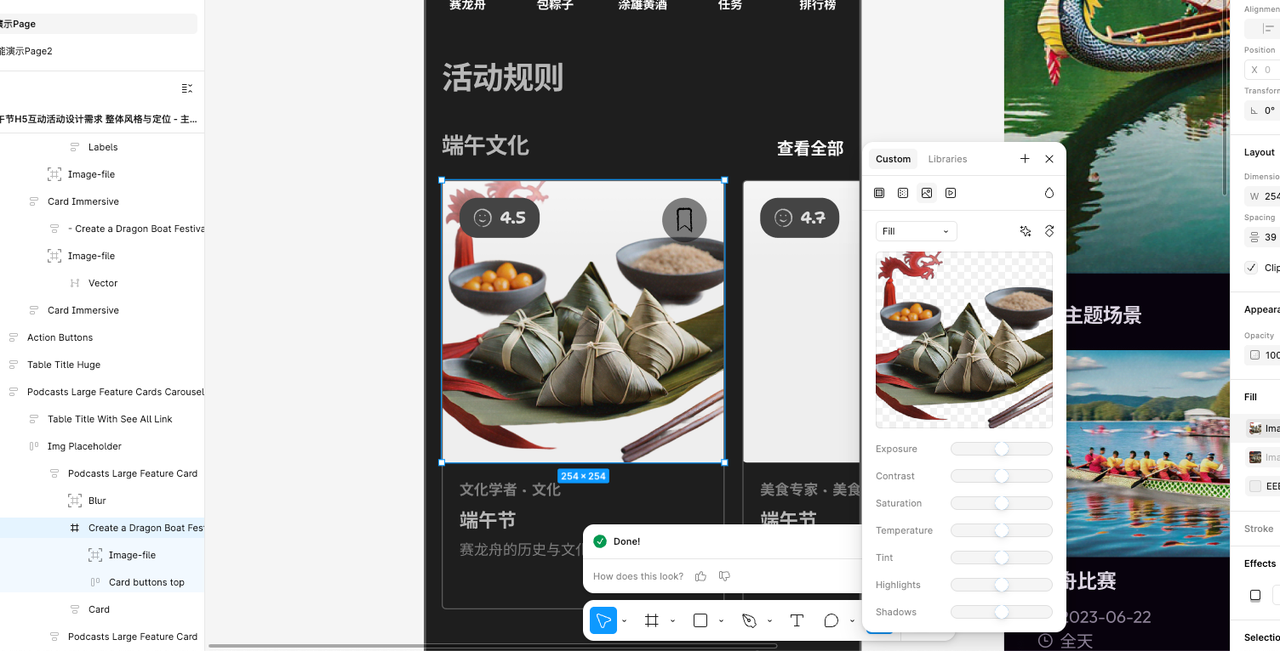
Sora的图像修改功能以及图像拼接功能:https://sora.com/g/gen_01jrwf4fafeqqr46172vbzqtsk
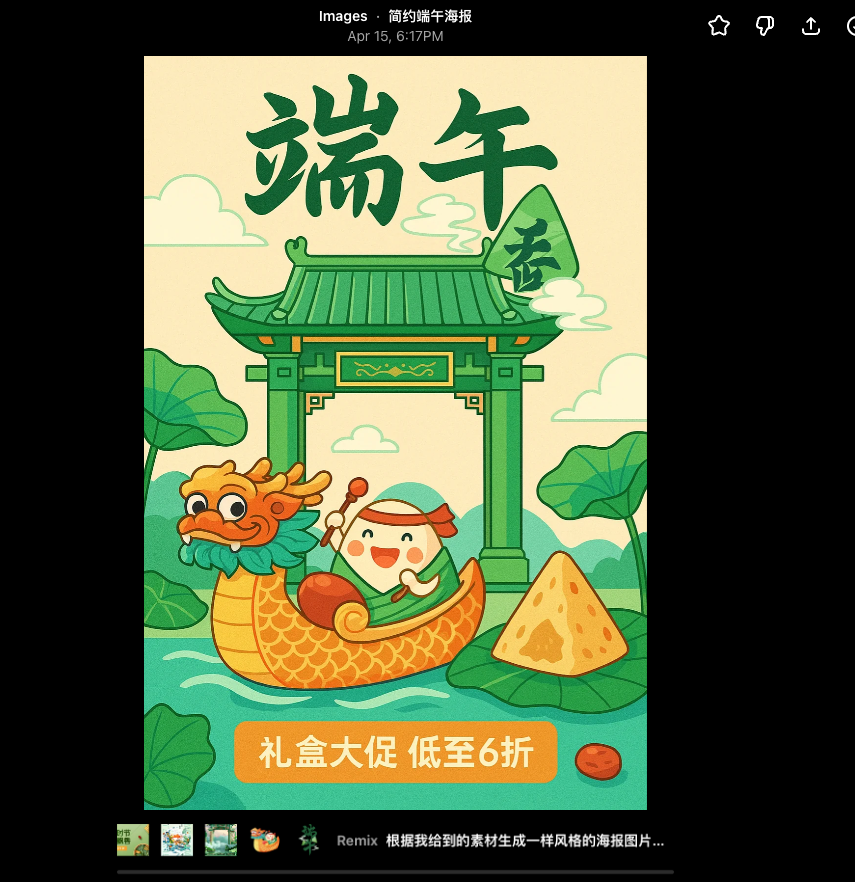
- same.new https://same.new/
复刻网站,比如taobao.com,比较需要时间,可能要20多分钟。因为比较费时间,这里直接看一下最后的复刻效果就行
完成效果:https://same-kqwehlm7o71-latest.netlify.app/
总结
目前总体看来,希望AI在工作环节中起到的作用是能够在某一些环节进行一些提效,比如AIGC素材的生成,普通页面的静态代码生成,在比较复杂的环节,依然需要人工介入才能实现表好的效果,通过这次分享,希望可以给大家一些思考和启发,在工作中不断尝试使用AI结合的方式来提升效率
本文标题:AI助力前端页面开发
文章作者:Niuhk
发布时间:2025-04-22
最后更新:2025-05-07
原始链接:https://www.niuhk.cn/2025/04/22/AI助力前端页面开发/
版权声明:转载请注明出处!
分享